Autor: Eduardo Fagundes

  • Escolha do local para data centers: resiliência territorial além de energia e conectividade

    Escolha do local para data centers: resiliência territorial além de energia e conectividade

    Em dezembro de 2025, uma reportagem do jornal O Estado de S. Paulo descreveu um episódio de interrupção relevante no fornecimento de energia na Grande São Paulo, após um evento climático severo. No mesmo contexto, registrou-se uma articulação institucional entre Ministério de Minas e Energia (MME), governo do Estado e prefeitura da capital para acionar a Agência Nacional de Energia Elétrica (Aneel) e iniciar trâmites regulatórios associados à concessão de distribuição. A matéria também reportou a coexistência de três elementos típicos em eventos desse tipo: efeitos operacionais prolongados para parte dos consumidores, mobilização e ações de recomposição pela distribuidora, e divergências sobre métricas e registros operacionais em temas como manutenção preventiva e podas preventivas.

    Este caso é citado aqui apenas como referência para uma tese prática:

    quando um data center decide onde se instalar, a análise não pode ficar restrita a preço e disponibilidade de energia, conectividade e condições imobiliárias.

    A decisão precisa incorporar parâmetros de resiliência territorial e de governança operacional do ecossistema local. Em linguagem de comitê de investimentos, trata-se de reduzir risco de cauda (tail risk) e aumentar previsibilidade do serviço, algo que impacta diretamente SLA (Service Level Agreement), reputação, custo total de propriedade e expansão futura.

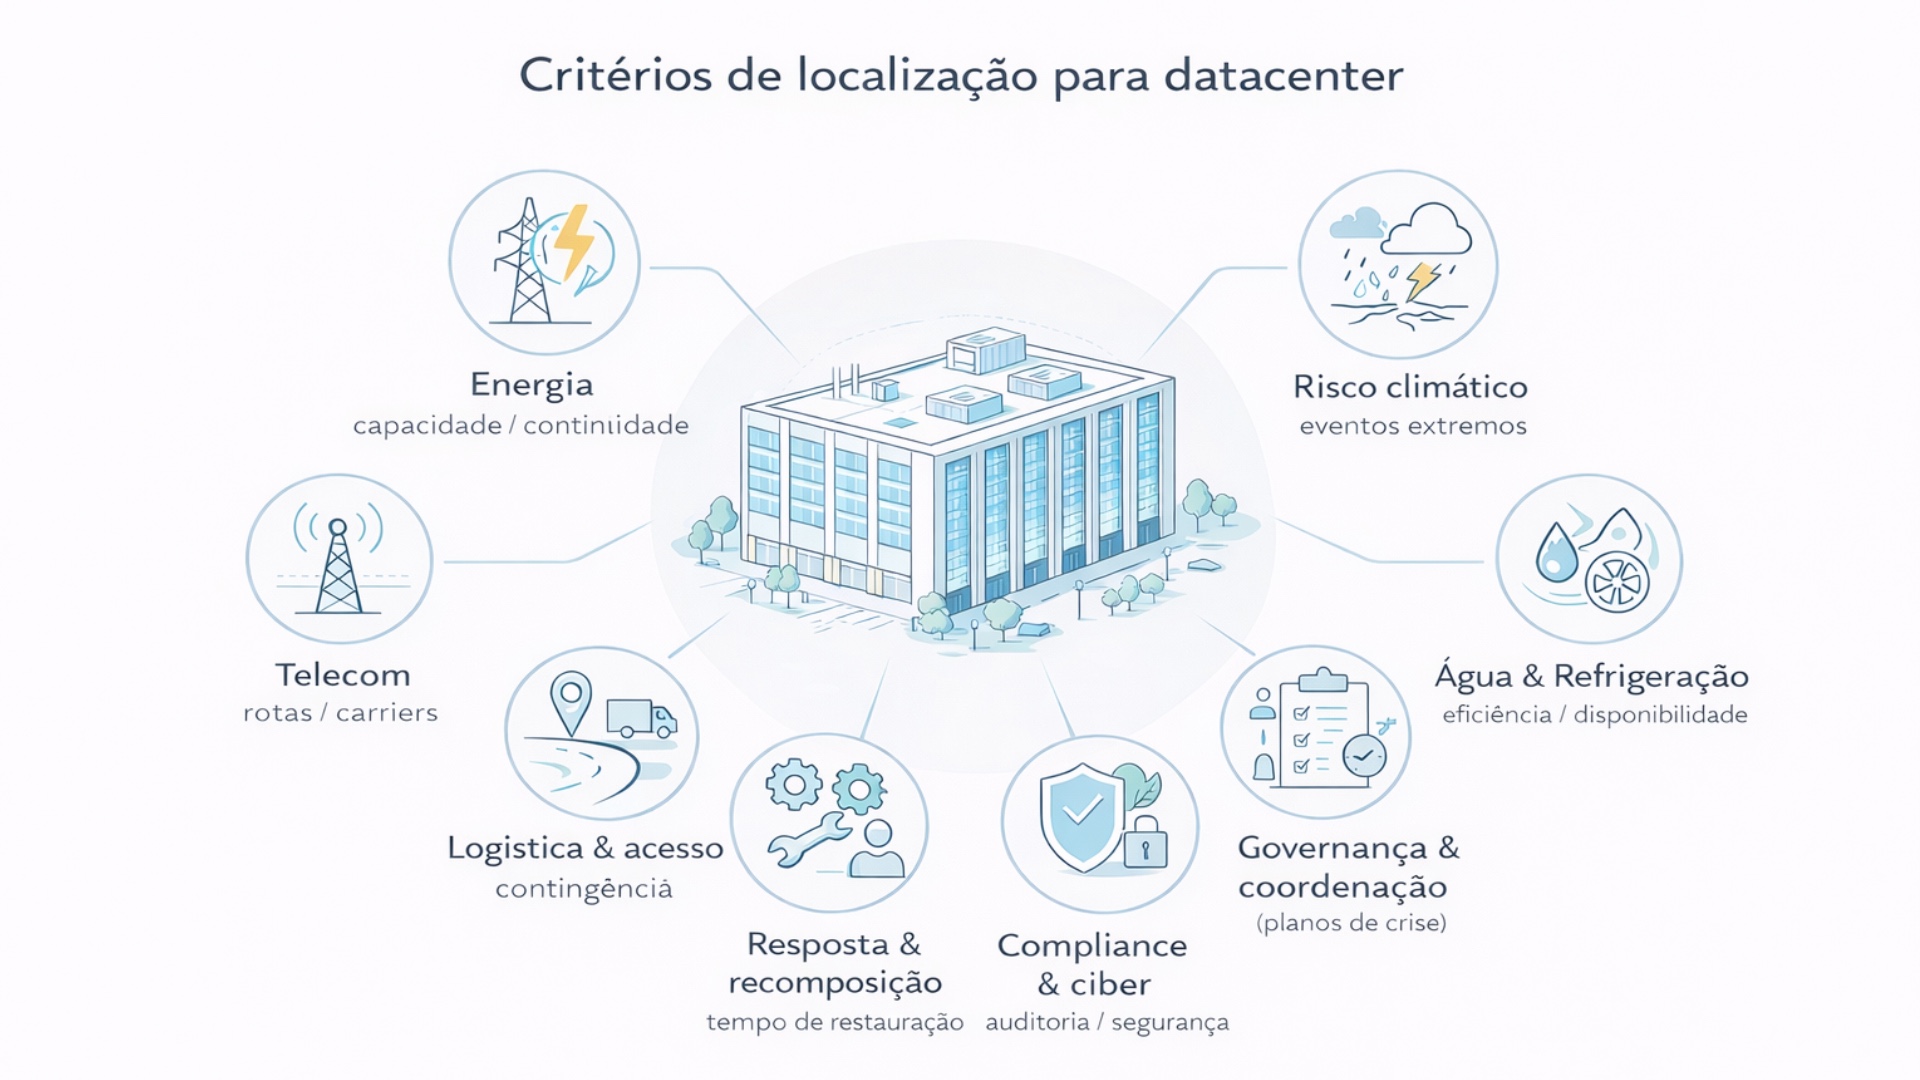
    A localização de um data center deve ser tratada como um problema de infraestrutura crítica e gestão de risco sistêmico. O site não é um “ponto no mapa”. É um nó em uma rede de dependências: distribuição elétrica, transmissão, telecom, logística, gestão urbana, protocolos de crise, capacidade institucional e coordenação entre atores. O diferencial competitivo está em transformar variáveis frequentemente “invisíveis” em critérios objetivos, auditáveis e comparáveis entre cidades e regiões.

    Em termos operacionais, a recomendação é adotar um modelo de diligência (due diligence) em duas camadas:

    Camada 1: pré-requisitos técnicos clássicos

    • Energia, telecom, imóvel/implantação, licenciamento e segurança física.

    Camada 2: resiliência territorial e governança

    • Qualidade histórica de continuidade do serviço, capacidade de resposta e recomposição, maturidade de gestão pública em crise, características urbanas que amplificam impactos (vegetação, drenagem, acesso), além de previsibilidade regulatória e institucional.

    O resultado esperado é uma seleção de local que minimize surpresas, acelere implantação, sustente expansão e permita arquiteturas de alta disponibilidade mais eficientes (isto é, menos dependentes de “overdesign” caro para compensar incertezas do território).

    O tripé clássico e o “quarto pilar” que costuma faltar

    1. Energia: A avaliação tradicional costuma priorizar capacidade de atendimento, custo marginal de energia, proximidade de subestações e viabilidade de conexão. Isso permanece necessário, porém insuficiente. Para data centers, energia também significa qualidade, continuidade e tempo de recomposição. A análise deve incluir indicadores e evidências.
    2. Telecom: A regra de ouro segue válida: diversidade real de rotas (não apenas diversidade de fornecedores), presença de múltiplos carriers, disponibilidade de backhaul, latência para pontos de troca e redundância física.
    3. Imóvel e implantação: Zoneamento, restrições ambientais, cronograma civil, riscos geotécnicos, acessibilidade logística e viabilidade de crescimento do campus.
    4. Resiliência territorial e governança: Aqui reside a mudança de patamar. O data center precisa avaliar se o território “se comporta bem” em estresse. Isso não é julgamento sobre atores. É uma leitura objetiva do sistema local e de como ele opera sob contingência.

    O que compõe resiliência territorial para data centers

    A seguir, um conjunto de dimensões recomendadas para incorporar ao modelo de seleção, mantendo tom estritamente técnico e descritivo.

    1. Qualidade de continuidade do serviço de distribuição elétrica

    O objetivo é quantificar e comparar o risco de interrupção e o comportamento de recomposição. Indicadores típicos incluem DEC (Duração Equivalente de Interrupção por Unidade Consumidora) e FEC (Frequência Equivalente de Interrupção por Unidade Consumidora), complementados por métricas internacionais como SAIDI (System Average Interruption Duration Index) e SAIFI (System Average Interruption Frequency Index), quando disponíveis ou inferíveis.

    Como usar esses indicadores sem ruído institucional

    • Tratar como insumo de engenharia, não como narrativa.
    • Comparar séries históricas e tendências, e não apenas um episódio.
    • Cruzar com perfil do território (densidade arbórea, rede aérea/subterrânea, topologia, corredores críticos).
    • Transformar em decisões de arquitetura: redundância de alimentação, dual feed, autonomia de UPS (Uninterruptible Power Supply), capacidade de geração, estratégia de combustível, contratos de manutenção e testes.

    2. Capacidade de resposta e recomposição em contingência

    Para data centers, o tempo de recomposição é tão importante quanto a probabilidade de interrupção. A diligência deve mapear, de forma objetiva, como o ecossistema local opera em crise: mobilização, logística, acesso ao local, coordenação com trânsito, comunicação, segurança e restabelecimento de serviços essenciais.

    Perguntas de diligência típicas

    • Existe plano de contingência público e atualizado?
    • Há rotinas de simulação (exercícios de mesa) e aprendizados incorporados?
    • Os canais de comunicação com a população e com empresas críticas são estruturados?
    • Há histórico de incidentes com recomposição rápida e previsível, e registros documentados?

    3. Gestão urbana que afeta diretamente infraestrutura

    Muitos riscos de data center são “urbanos” antes de serem “elétricos”. Exemplos clássicos: quedas de árvores, alagamentos, obstrução de vias e impactos em cabos e postes. A diligência deve considerar:

    • Arborização e interferências com rede: Mapear corredores críticos, rotinas de poda preventiva, cadastros de árvores de risco e integração de informações entre atores. O ponto aqui é reduzir variabilidade e incerteza, especialmente em eventos extremos.
    • Drenagem e alagamentos: Checar histórico de alagamento, capacidade de drenagem, obras e manutenção, e a exposição de rotas de acesso ao campus. O que derruba um data center muitas vezes não é a sala elétrica; é a impossibilidade de acesso, reabastecimento e operação logística.
    • Ilhas de calor e microclima: Avaliar impactos no desenho de refrigeração, resiliência de HVAC (Heating, Ventilation and Air Conditioning) e riscos associados a ondas de calor.

    4. Capacidade institucional e coordenação interorganizacional

    Em crises, a performance do sistema depende de coordenação. Para data centers, isso se traduz em: previsibilidade de licenciamento, agilidade de respostas, clareza de papéis e capacidade de integração. Uma prática recomendada é exigir evidências de governança, não promessas.

    Ferramenta prática

    Construir uma matriz RACI (Responsible, Accountable, Consulted, Informed) para implantação e operação em contingência, deixando claro quem é responsável, quem aprova, quem é consultado e quem precisa ser informado, em temas como:

    • acesso e perímetro
    • interdições e rotas alternativas
    • resposta a incidentes e segurança
    • comunicação com a comunidade e com clientes críticos

    5. Previsibilidade regulatória, institucional e de expansão

    Data centers são projetos de ciclo longo. A decisão de localização deve avaliar a previsibilidade das regras do jogo: licenças, obras de infraestrutura, expansão do sistema elétrico e telecom, e coerência de políticas públicas locais com infraestrutura crítica e economia digital.

    Aqui, a melhor prática corporativa é tratar a previsibilidade como risco mensurável:

    • lead time histórico de licenças semelhantes
    • estabilidade de requisitos e padrões
    • capacidade de emitir autorizações e fiscalizações com cadência previsível
    • qualidade de documentação e transparência de processos

    Como transformar isso em modelo decisório: a matriz multicritério

    Uma abordagem eficaz para o comitê é criar uma matriz multicritério com pesos e pontuações, evitando decisões baseadas em impressões. Recomenda-se usar uma escala simples (por exemplo, 1 a 5) e pesos por criticidade, com evidência mínima exigida por critério. Exemplo de estrutura:

    BlocoFocoPesoCritérios de avaliação
    AInfraestrutura essencialAltoEnergia: capacidade, expansão, redundância, qualidade e continuidade. Telecom: diversidade de rotas, múltiplos carriers, latência, redundância. Água e refrigeração: disponibilidade e estratégia (incluindo alternativas de baixo consumo).
    BRisco físico e climáticoAltoVentos extremos, tempestades, descargas atmosféricas, alagamentos, incêndios e ondas de calor. Acesso e logística sob contingência.
    CResiliência territorial e governançaAltoHistórico de continuidade e recomposição. Capacidade de coordenação e planos de crise. Gestão urbana relevante (arborização, drenagem, obras e manutenção).
    DImplantação e operaçãoMédioMão de obra técnica, fornecedores, suporte de O&M (Operations and Maintenance), segurança do entorno.
    ECompliance e reputaçãoMédioRequisitos ambientais, auditorias, segurança cibernética e rastreabilidade de decisões.

    O ganho dessa matriz é padronizar o debate. Se o território é excelente em energia e telecom, mas tem baixa previsibilidade de recomposição ou alto risco urbano, isso aparece numericamente. E, quando aparece, a empresa pode reagir com duas alavancas: escolher outro local ou compensar com arquitetura (o que tem custo). O essencial é que a decisão se torne consciente e auditável.

    Diligência de campo: o que fazer além do “Google e planilha”

    Para evitar que a análise vire um exercício teórico, recomenda-se uma diligência em três etapas, com governança clara e documentação.

    Etapa 1: triagem e shortlist

    Selecionar regiões candidatas com base em pré-requisitos e dados públicos: energia e telecom, clima, logística, zoneamento e disponibilidade de áreas.

    Etapa 2: diligência estruturada com evidências

    • Coleta de indicadores de continuidade e recomposição, com séries históricas quando possível.
    • Entrevistas técnicas com atores relevantes, em formato padronizado.
    • Visitas de campo para validação de rotas, acessos, drenagem, entorno e interferências.
    • Verificação de planos de contingência e rotinas de coordenação.

    Etapa 3: simulação e validação de resiliência

    Conduzir um tabletop exercise (exercício de mesa) com cenários plausíveis: tempestade severa, alagamento em rotas de acesso, queda de árvore e bloqueio parcial, falha regional de telecom. O objetivo é testar a lógica de resposta e a capacidade de coordenação, não avaliar pessoas.

    Como isso reduz custo e aumenta performance do data center

    Um ponto de gestão: quando o território é incerto, a tendência é compensar com CAPEX (Capital Expenditure) elevado em redundância e autonomia. Isso funciona, mas pode ser caro e subótimo. Um território mais previsível permite:

    • arquitetura mais eficiente, com redundância calibrada
    • menor risco de indisponibilidade prolongada por fatores externos
    • melhor cumprimento de SLA (Service Level Agreement) com menor custo marginal
    • maior confiança para expansão do campus, reduzindo risco de “estrangulamento” por licenças ou infraestrutura

    Do ponto de vista estratégico, isso também melhora a narrativa para clientes corporativos: o data center não vende apenas megawatts e racks. Vende continuidade como produto.

    Recomendação executiva: checklist mínimo para decisão de localização

    Para fechar, um checklist mínimo, adequado para uso em comitê:

    1. Energia: Indicadores históricos de continuidade (DEC/FEC) e leitura de recomposição. Plano de expansão e redundância de alimentação. Qualidade de energia e incidência de distúrbios relevantes.
    2. Telecom: Dois ou mais caminhos físicos independentes, validados em campo. Múltiplos carriers com rotas não correlacionadas.
    3. Risco físico e climático: Histórico e projeções de eventos extremos. Drenagem e acessos sob contingência.
    4. Resiliência territorial: Evidências de planos de crise e coordenação. Capacidade de resposta e comunicação. Gestão urbana relevante (vegetação, obras, manutenção de vias).
    5. Governança e previsibilidade: Licenciamento com trilha clara e prazos realistas. Matriz RACI para implantação e operação em contingência. Documentação e rastreabilidade para auditoria e clientes.

    Conclusão

    A seleção do local de um data center precisa evoluir do “tripé clássico” para um modelo de decisão orientado a resiliência territorial. O caso reportado pelo Estadão em dezembro de 2025, descrito aqui de forma neutra, é um lembrete de que eventos extremos e impactos em serviços essenciais podem acionar processos regulatórios e institucionais de grande complexidade. Para um data center, isso se traduz em risco operacional, reputacional e financeiro.

    A boa prática corporativa é simples e sofisticada ao mesmo tempo: incluir critérios adicionais, tratá-los com evidências, transformá-los em matriz comparável e governar a decisão com disciplina. É assim que se protege a continuidade digital, sem depender de suposições, e com uma visão de futuro que valoriza o básico bem feito: engenharia, redundância calibrada, processos claros e governança madura do território.

    Como podemos ajudar

    Podemos ajudar como uma camada independente de inteligência e governança para suportar a decisão de localização de data centers, reduzindo risco e aumentando previsibilidade para o comitê executivo e para investidores, sem personalizar discussões ou atribuir responsabilidades a atores locais.

    Entregáveis recomendados

    1. Framework de decisão e matriz multicritério: Estruturação do modelo Bloco A–E com pesos, critérios, evidências mínimas exigidas e método de pontuação comparável entre cidades/regiões, gerando uma shortlist auditável e defensável.
    2. Diligência de resiliência territorial: Compilação e normalização de indicadores públicos e operacionais (continuidade, recomposição, risco físico/climático, logística em contingência), com leitura técnica orientada a impacto em SLA (Service Level Agreement), TCO (Total Cost of Ownership) e expansion readiness.
    3. Relatório executivo para Investment Committee: Documento “board-ready” com: racional da decisão, trade-offs, riscos de cauda (tail risks), cenários e recomendações de mitigação (arquitetura, redundância, processos e governança), em linguagem adequada para diretoria e stakeholders.
    4. Cenários e stress test operacional: Condução de tabletop exercise (exercício de mesa) com cenários realistas (tempestade, alagamento, falha regional de telecom, restrição de acesso), produzindo plano de ação, matriz RACI (Responsible, Accountable, Consulted, Informed) e recomendações de contingência.
    5. Estratégia de relacionamento institucional e comunicação neutra: Desenho de roteiro de engajamento técnico com atores locais (distribuição, telecom, município e órgãos de resposta), com Q&A e pacotes de mensagens neutras e descritivas para reduzir ruído e acelerar alinhamentos durante implantação e operação.
    6. Roadmap de mitigação e arquitetura: Tradução dos achados em decisões de engenharia (redundância, dual feed, autonomia de UPS (Uninterruptible Power Supply), geração, combustível, rotas alternativas, contratos de O&M (Operations and Maintenance)), com priorização por impacto e custo.

    Resultado esperado

    Uma decisão de localização mais robusta, com rastreabilidade e governança, que reduz risco operacional e reputacional, melhora a previsibilidade de implantação e fortalece a narrativa de resiliência do data center para clientes corporativos e investidores.
  • Resiliência Operacional em Eventos Climáticos Severos: Checklist Prático para Municípios e Empresas

    Resiliência Operacional em Eventos Climáticos Severos: Checklist Prático para Municípios e Empresas

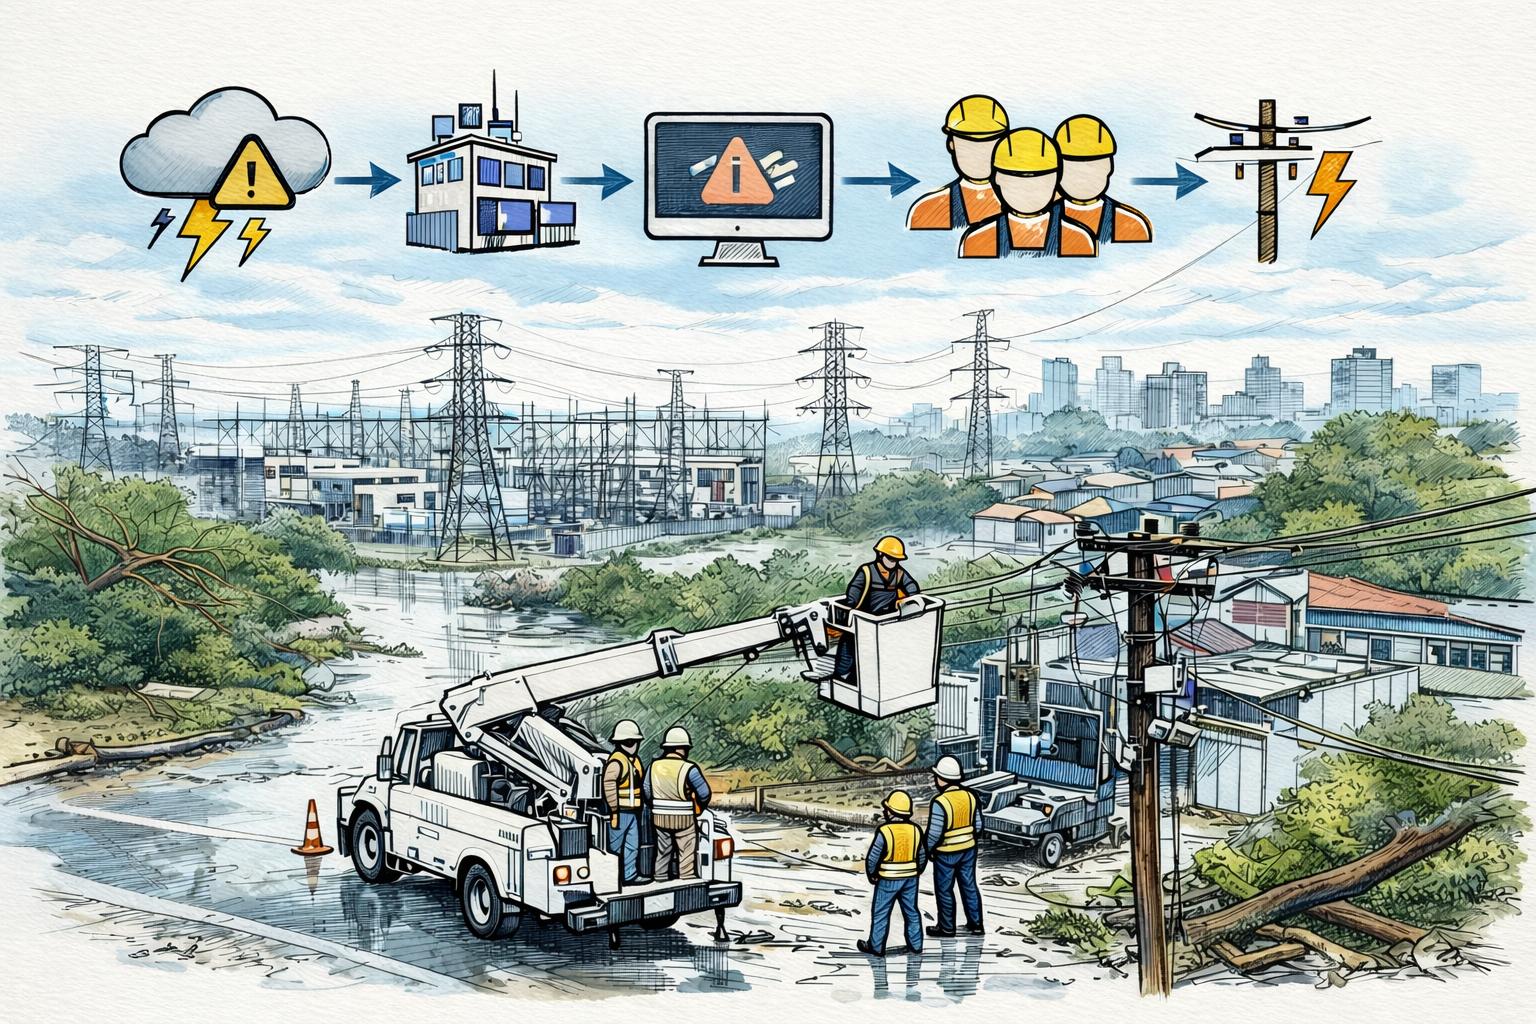
    Eventos climáticos severos passaram a operar como um risco estrutural, não como contingência rara. Em áreas urbanas densas, o impacto real não é definido apenas pela intensidade do evento, mas pelo grau de preparo para reduzir o tempo entre detecção, decisão e execução. Quando esse ciclo falha, os efeitos em cascata aparecem rapidamente: congestionamento, quedas de árvores, acesso bloqueado a pontos críticos, aumento de acidentes, interrupções prolongadas, perda de atividade econômica, judicialização e deterioração da confiança pública.

    Isso muda o gatilho de investimento. Resiliência deixa de ser um tema “técnico do setor elétrico” e passa a ser uma agenda de continuidade urbana e competitividade econômica. Para municípios, trata-se de assegurar serviços essenciais e governança de crise. Para empresas e utilities, trata-se de proteger receita, reduzir custo total de recomposição, manter indicadores regulatórios sob controle e mitigar risco reputacional e de seguros.

    Objetivo do artigo: apresentar um checklist para o direcionamento dos esforços

    O objetivo deste artigo é fornecer uma abordagem prática para a resiliência operacional em situações de crise, com foco na aplicação de checklists que ajudem tanto os gestores públicos quanto as empresas a gerenciar e mitigar os impactos de eventos climáticos severos. A lógica por trás desse método é simples: ao mapear de forma objetiva as áreas essenciais que precisam de atenção, podemos direcionar esforços de maneira mais eficiente, reduzir falhas operacionais e melhorar a capacidade de resposta.

    Checklists de Resiliência

    Os itens dos checklists não devem ser vistos como uma simples “lista de compras”. Eles refletem uma cadeia causal clara e estratégica, que visa garantir a eficácia da resposta a eventos adversos. A ideia central é reduzir a duração e a abrangência das interrupções. Para isso, é necessário evitar o improviso, reduzir o atrito organizacional e aumentar a precisão operacional sob estresse. Isso significa que cada item do checklist está diretamente relacionado a uma ação específica que impacta a agilidade e a eficácia da resposta — seja em termos de preparação, coordenação, comunicação ou execução.

    Portanto, o checklist serve como uma ferramenta de gestão de crise, permitindo que todas as partes envolvidas — desde os gestores públicos até as equipes operacionais — possam agir de forma coordenada, com clareza sobre suas responsabilidades e prazos. Isso resulta em uma execução mais ágil, uma maior capacidade de adaptação às circunstâncias e, consequentemente, uma resposta mais eficaz aos desafios impostos pelos eventos climáticos severos.

    A seguir os seis pilares que sustem os checklists.

    1. Consciência situacional e priorização
    • Em crise, informação fragmentada gera despacho duplicado, retrabalho e alocação errada de recursos. Por isso entram itens como mapa de risco, lista de cargas críticas, sala de situação, e sistemas de gestão de ocorrências.
    • Para o poder público, o objetivo é saber o que proteger primeiro e como coordenar atores diferentes com uma linguagem comum de prioridade. Para empresas, o objetivo é correlacionar sinais e reclamações a uma causa-raiz e transformar dados em fila de execução, com priorização por impacto.
    1. Velocidade operacional antes do evento
    • A maior alavanca de performance está no antes. Após o evento, a cidade perde mobilidade e o custo do deslocamento explode. Por isso entram gatilhos meteorológicos, pré-posicionamento, contratos e credenciamentos prévios, kits e bases avançadas.
    • A lógica é reduzir o tempo morto e aumentar taxa de resolução na primeira visita. Sem logística descentralizada e materiais prontos, qualquer equipe vira “carro de passeio” preso na malha urbana.
    1. Arquitetura de equipes e produtividade de campo
    • Crises ampliam o volume de ocorrências e expõem um problema clássico: recurso pesado indo para tarefa leve, e vice-versa. Daí a necessidade de segmentar funções (resposta rápida, apoio, pesada) e treinar para tipologias específicas.
    • Esse desenho não é burocracia. É uma forma de multiplicar capacidade efetiva sem multiplicar custo, porque aumenta produtividade por ciclo de trabalho e reduz retrabalho.
    1. Automação, proteção e seletividade
    • Automação e self-healing só geram valor se atuarem corretamente, no ponto correto, com parâmetros alinhados à topologia real da rede. Quando proteção e automação falham, o desligamento se amplia desnecessariamente e derruba blocos maiores do que o mínimo técnico.
    • Por isso o checklist exige revisão periódica de coordenação de proteção, telemetria de disponibilidade da automação, testes e governança de parâmetros. A tese é reduzir área desligada e acelerar recomposição, mantendo segurança operacional.
    1. Centros de operação escaláveis e comando e controle
    • Em eventos severos, a quantidade de equipes e ocorrências pode transformar o centro de operação centralizado em gargalo cognitivo e de despacho. É aí que entram subcentros regionais temporários, despachantes regionais treinados e um desenho de escalabilidade.
    • A lógica é manter o centro principal focado nos problemas de maior impacto e delegar, com método, o volume de ocorrências simples. Isso reduz fila, atrito e tempo de resposta.
    1. Governança e comunicação em crise
    • Sem cadeia de comando simples, critérios objetivos de escalonamento e ritos claros, a operação vira debate e a execução perde cadência. Em paralelo, a percepção pública piora quando a comunicação é reativa e inconsistente.
    • Por isso aparecem itens de governança de crise, protocolos formais entre município e distribuidora, e planos de comunicação com mensagens pré-formatadas e cadência definida. Isso reduz risco institucional e estabiliza expectativas.

    Por que existem dois checklists

    A separação entre gestores públicos e empresas é intencional. O município não opera rede elétrica, mas opera a continuidade da cidade. Ele precisa coordenar atores, destravar acesso, priorizar serviços essenciais e reduzir danos sociais. Já empresas e utilities precisam garantir execução técnica com eficiência, reduzindo falhas sistêmicas e recuperando carga com segurança.

    Quando os dois checklists convergem, a cidade responde melhor e a operação técnica ganha velocidade, porque a governança urbana não vira obstáculo.

    Como transformar checklist em plano investível

    O checklist vira programa quando cada item é convertido em quatro camadas de gestão:

    • baseline: o que existe, com evidência operacional, não apenas documento
    • lacunas: o que está ausente e impacta diretamente tempo/área desligada
    • roadmap: quick wins (60–90 dias) e frentes estruturais (6–12 meses)
    • KPIs (Key Performance Indicators): métricas de prontidão e resposta, além dos indicadores tradicionais pós-evento

    Como podemos ajudar

    O think-tank conduz a consultoria para estruturar tese, diagnóstico, desenho de governança, business case e KPIs, garantindo alinhamento com risco urbano, risco regulatório e retorno econômico. A nMentors conduz o projeto de implantação, integrando sistemas, desenhando rotinas operacionais, capacitando equipes, implementando gestão de mudanças e sustentando a governança de execução em uma plataforma de gestão de projetos online.

    Conclusão

    Eventos severos tendem a continuar. O diferencial competitivo e institucional será a disciplina operacional: preparo antecipado, informação acionável, logística descentralizada, automação que realmente atua, centros de operação escaláveis e governança de crise sem improviso. Os checklists existem para garantir que resiliência seja executável e mensurável, e não apenas uma intenção.

    Checklists

    Checklist de Resiliência para Gestores Públicos

    Item de verificaçãoJá implantadoEm implantaçãoPriorizarNão aplicável
    Mapa municipal de risco climático (por bairros/corredores críticos) integrado ao plano de contingência
    Sala de situação multissetorial ativável (energia, defesa civil, mobilidade, saúde, telecom, segurança) com ritos e gatilhos
    Protocolo formal com a distribuidora para “modo tempestade” (pontos focais, SLAs (Service Level Agreement), escalonamento, comunicação)
    Lista de serviços essenciais e cargas críticas (hospitais, UPAs, abrigos, semáforos, água/esgoto, telecom) com priorização operacional
    Plano de continuidade para mobilidade urbana (rotas alternativas, acesso a subestações/áreas de manutenção, liberação rápida de vias)
    Protocolo de manejo de arborização/vegetação em áreas de rede (poda preventiva e resposta pós-evento)
    Contratos/credenciamento prévio para resposta emergencial (remoção, iluminação, sinalização, limpeza, apoio logístico)
    Plano de comunicação com o cidadão (alertas, status, canais oficiais, orientação de segurança) com mensagem pré-formatada
    Indicadores de prontidão e resposta (tempo de mobilização, tempo de desobstrução, tempo de atendimento por bairro, percepção do cidadão)
    Simulados anuais (ou semestrais) com a rede de órgãos e concessionárias, com lições aprendidas e plano de ação
    Plano de infraestrutura de apoio (abrigos com energia, geradores, combustível, conectividade mínima)
    Governança de crise: cadeia de comando simples, substituições definidas e gatilhos objetivos de escalonamento

    Checklist de Resiliência para Empresas e Utilities

    Item de verificaçãoJá implantadoEm implantaçãoPriorizarNão aplicável
    “Storm mode” operacional: gatilhos meteorológicos, pré-posicionamento de equipes e plano de mobilização em cascata
    Arquitetura funcional de equipes (resposta rápida, apoio, pesada) com treinamento e despacho por tipologia
    Bases avançadas e logística descentralizada (estoque mínimo, kits padronizados, reposição)
    KPI de produtividade de campo (first-time fix, ocorrências por ciclo, tempo de deslocamento, retrabalho)
    OMS (Outage Management System) com correlação por causa-raiz e integração com topologia/GIS/telemetria
    Centro de operação escalável (subcentros regionais temporários, despachantes regionais treinados)
    Automação e self-healing com telemetria de disponibilidade, testes periódicos e governança de parâmetros
    Coordenação de proteção (ajustes, seletividade, revisões periódicas pós-mudança de rede/carga)
    Monitoramento preditivo/IA para detecção precoce de falhas (linhas, vegetação, isolação, ativos críticos)
    Plano de ciber-resiliência OT/IT (segmentação, resposta a incidentes, continuidade degradada)
    Governança de crise (cadeia de comando, critérios objetivos, war room, ritos, lições aprendidas)
    Plano de comunicação externa (regulador, imprensa, clientes críticos) com mensagens e cadência predefinidas

  • Reprecificação da infraestrutura digital em 2026: Edge Inference e data centers regionais como tese de investimento

    Reprecificação da infraestrutura digital em 2026: Edge Inference e data centers regionais como tese de investimento

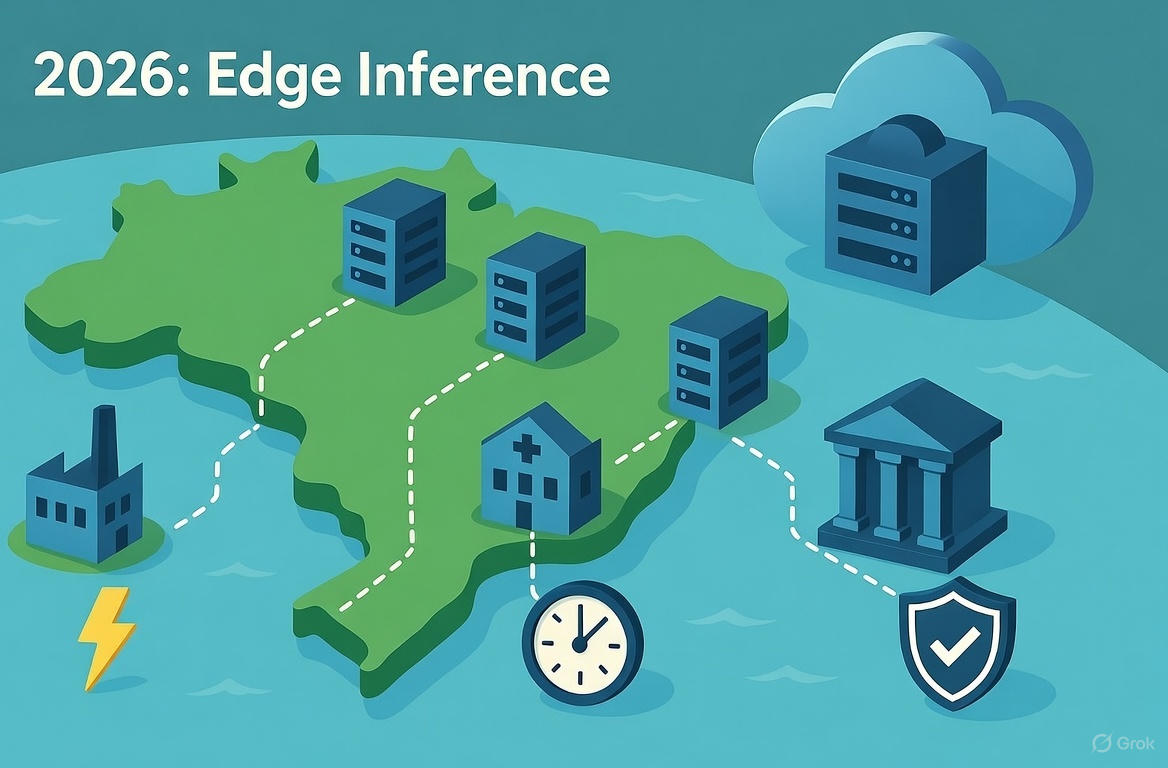
    O mercado de infraestrutura digital está passando por uma transição estratégica significativa, impulsionada pela maturação da Inteligência Artificial (IA) e pela crescente necessidade de eficiência operacional. Os grandes hyperscalers, como AWS, Azure e Google Cloud, dominaram o cenário de TI com soluções padronizadas e infraestrutura de treinamento para grandes modelos de IA, como os Large Language Models (LLMs). No entanto, uma nova oportunidade surge no horizonte para fornecedores regionais e players de Edge Computing, que podem capturar a crescente demanda por infraestrutura especializada e otimizada para inferência de IA.

    A convergência de duas fontes — o artigo da TechRepublic e o relatório do Gartner — valida esta tese de investimento, destacando três áreas-chave de diferenciação para a infraestrutura regional de 2026: especialização do hardware, soberania digital e autonomia arquitetural. A seguir, exploramos essas mudanças com base em insights técnicos e geopolíticos que criam uma janela estratégica para investidores menores e regionais.

    1. A Especialização do Hardware como Novo Motor de Vantagem Competitiva

    A TechRepublic aponta que a era da infraestrutura genérica está chegando ao fim. Em um cenário onde a eficiência por transação e a latência são críticas, a infraestrutura tradicional baseada em servidores padronizados já não atende mais às demandas de IA em produção. Em 2026, a infraestrutura de IA se tornará mais especializada, com hardware co-projetado para workloads específicos, como inferência de IA, ao invés de apenas treinamento. Esse ponto é validado pela afirmação do COO de Infraestrutura da IBM, que prevê que “a era da infraestrutura de IA genérica chegará ao fim em 2026” .

    Essa especialização cria uma vantagem competitiva para datacenters menores, que podem fornecer soluções localizadas e otimizadas para setores específicos, como indústria, finanças e governança, onde a proximidade com os dados e a baixa latência são cruciais.

    2. Soberania e Conformidade como Drivers de Fragmentação do Mercado

    O relatório do Gartner reforça que a localização física dos dados passou a ser uma questão crítica de segurança e conformidade, impulsionada por crescentes pressões regulatórias e geopolíticas. Em vez de depender de grandes provedores globais, muitos CIOs estão repensando seu mix de fornecedores e adotando soluções regionais, com foco na soberania digital. Isso é especialmente importante para dados sensíveis, como os financeiros ou governamentais, onde os riscos de conformidade com leis internacionais, como o Cloud Act, são uma preocupação crescente.

    Ao garantir que os dados nunca cruzem fronteiras, as infraestruturas regionais podem atender a esse requisito de soberania, oferecendo soluções mais confiáveis e juridicamente seguras, algo que os grandes provedores globais têm dificuldade em garantir de forma universal. Para os investidores locais, isso representa uma oportunidade única de construir datacenters soberanos que atendam aos requisitos de conformidade e segurança sem as limitações impostas pelos contratos globais.

    3. Autonomia Arquitetural e Modularidade

    A TechRepublic destaca que a autonomia está substituindo o lock-in (aprisionamento) em arquiteturas de nuvem, com empresas cada vez mais buscando ambientes que permitam flexibilidade e liberdade para mover workloads sem dependência de um único provedor. A tendência de “autonomy replaces lock-in” significa que as empresas não querem mais ser reféns de contratos longos e inflexíveis com hyperscalers. Em vez disso, elas buscam soluções modulares e descentralizadas que ofereçam maior controle e flexibilidade operacional .

    Em 2026, o modelo ideal será híbrido, utilizando grandes nuvens públicas para tarefas pesadas e infraestrutura regional ou Edge para inferência crítica, onde latência e confiabilidade são essenciais. Para os investidores regionais, isso significa que a arquitetura modular, com foco na flexibilidade e autonomia, será a chave para capturar o valor da próxima geração de IA.

    Tabela de Comparação: Critérios de Decisão e Validação nas Fontes

    A tabela a seguir resume os principais critérios de decisão para os dois modelos de infraestrutura — tradicional (Hyperscalers) e o novo modelo para 2026 (Edge/Regional). As duas fontes convergentes, Gartner e TechRepublic, são usadas para validar os argumentos apresentados.

    Critério de DecisãoModelo Tradicional (Hyperscalers / Treinamento)Novo Modelo 2026 (Regional / Inferência)Validação nas Fontes
    InfraestruturaGenérica, padronizada, “One-size-fits-all”.Especializada, co-projetada para workload (latência/energia).TechRepublic: Fim da era da infraestrutura genérica.
    Foco do WorkloadTreinamento de Modelos Gigantes (LLMs).Inferência em Produção e Agentes Autônomos.TechRepublic: Agentes autônomos operando com pouca supervisão.
    Soberania de DadosConfiança em contratos globais (Cloud Act risk).Garantia física de residência e conformidade local.Gartner: Repensar mix global/regional por risco e soberania.
    ArquiteturaLock-in em ecossistemas proprietários.Modularidade e Autonomia (evitar aprisionamento).TechRepublic: “Autonomy replaces lock-in”.
    KPI FinanceiroElasticidade a qualquer custo.Eficiência por transação e AI ROI real.Gartner: Foco em “AI ROI” e impacto no balanço.

    Gráfico: A Matriz de Valor em Infraestrutura Digital para 2026

    O gráfico abaixo ilustra a transição da infraestrutura digital em 2026, com foco na mudança de valor do modelo genérico dos hyperscalers para a especialização regional e de Edge Computing. Como podemos ver, a “Zona Saturada” (domínio dos hyperscalers) está ficando saturada pela “guerra de preços” no treinamento massivo, enquanto a “Zona de Oportunidade” (infraestrutura de inferência e soberania) começa a ganhar terreno à medida que os dados e as demandas de IA exigem maior especialização.

    Conclusão

    A análise do Gartner e da TechRepublic mostra que 2026 será um ano de reprecificação da infraestrutura digital, com um movimento claro em direção a soluções regionais e especializadas em IA. A infraestrutura genérica perde terreno para soluções sob demanda, focadas na inferência, na soberania dos dados e na flexibilidade arquitetural. Para os investidores regionais, esta é uma oportunidade estratégica de capturar valor em um mercado fragmentado, onde a proximidade com os dados e a eficiência operativa serão os principais diferenciadores.

    Referências

    TICONG, Liz. 7 Tech Predictions Enterprise Leaders Are Watching in 2026. TechRepublic, 12 dez. 2025. Disponível em: https://www.techrepublic.com/article/news-2026-tech-predictions-industry-experts/. Acesso em: 15 dez. 2025. 

    GARTNER. CIO Agenda 2026: What Top Tech Leaders Do Differently. YouTube, 11 dez. 2025. Disponível em: https://www.youtube.com/watch?v=LNfPQ4d570g. Acesso em: 15 dez. 2025. 

  • Radar 360 – Economia, IA, Energia e Risco Político no Brasil (06/12–12/12/2025)

    Radar 360 – Economia, IA, Energia e Risco Político no Brasil (06/12–12/12/2025)

    Período: sábado 06/12/2025 a sexta 12/12/2025

    1) Resumo executivo

    1. Política monetária manteve o modo “defesa”: o Copom (Comitê de Política Monetária) preservou a Selic em 15% a.a., reforçando o custo de capital e o filtro mais duro para CAPEX (Capital Expenditure) em 2026. 
    2. Choque climático-operacional em São Paulo: ciclone extratropical gerou apagão relevante, afetando água e logística urbana; a Aneel cobrou explicações da concessionária, elevando a sensibilidade do tema “resiliência de rede” no debate público e regulatório. 
    3. Descompressão institucional externa: os EUA removeram Alexandre de Moraes, esposa e entidade associada da lista Global Magnitsky, reduzindo ruído de sanções e abrindo espaço para normalização diplomática no curto prazo. 
    4. Regulação habilitadora da transição: a Aneel abriu consulta pública (CP42/2025) para aprimorar regras de conexão de eletromobilidade (carregadores de veículos elétricos) à rede de distribuição, sinalizando agenda pró-escala com governança técnica. 
    5. Infraestrutura global de IA (Inteligência Artificial) segue em aceleração: (i) Amazon anunciou plano de investimento de mais de US$ 35 bi na Índia até 2030, com ênfase em IA e logística; (ii) tese “data center fora da Terra” entrou no radar com Blue Origin; (iii) Coreia do Sul reforçou ambição industrial em semicondutores, com foco em foundry. 
    6. Sinais de ciência e saúde: FDA aprovou a primeira terapia gênica para uma doença imune rara, enquanto crises sanitárias (cólera na RDC e nova variante recombinante de mpox no Reino Unido) lembram que risco sistêmico não é só macro e geopolítica. 

    2) Método do Radar 360 (para manter comparabilidade)

    Escala comum (−2 a +2) e indicadores-base do Radar 360 conforme o modelo de relatório: RBA (Risco Brasil Ampliado), PER (Pulso da Economia Real), QTR (Qualidade do Trabalho e Renda), VTT (Vetor de Transformação Tecnológica e IA), PEC (Pressão Energética e Climática), SPG (Stress Político-Regulatório e Geopolítico). 

    3) Painel dos indicadores Radar 360 (semana 06–12/12/2025)

    IndicadorValorLeitura da semana
    RBA0Risco misto: juros altos travam apetite a risco, mas melhora marginal no ruído externo de sanções. 
    PER0Economia segue em “cruzeiro operacional”; custo do dinheiro permanece como teto de crescimento. 
    QTR-1Mercado de trabalho pode estar “forte” no headline, mas renda/qualidade seguem como ponto de atenção (pressão social e de demanda).
    VTT+1Infra global de IA continua expandindo (nuvem, chips, data centers); implicação direta em produtividade e competição. 
    PEC-1Evento extremo em SP materializa risco climático-operacional e reabre debate sobre resiliência, manutenção e resposta. 
    SPG0Descompressão via Magnitsky ajuda, mas o sistema segue com alto “beta institucional” e sensível a choques. 

    4) Macro e mercados

    Copom manteve Selic em 15% a.a.; leitura tática: custo de capital continua como régua de governança, exigindo ROI (Return on Investment) mais robusto e cronogramas de payback mais curtos em 2026. 

    5) Tecnologia e IA

    Três vetores práticos para estratégia 2026:

    1. Capacidade computacional como insumo crítico: planos de investimento em IA (Inteligência Artificial) e cadeias de suprimento (nuvem, chips, data centers) reforçam disputa por energia, semicondutores e talento. Implicação: quem tiver contratos de energia e arquitetura eficiente escala mais rápido.
    2. Data centers como tema de soberania e infraestrutura: a discussão migra de “TI” para infraestrutura crítica, com peso em licenciamento, água, rede elétrica e narrativa ESG (Environmental, Social and Governance). Implicação: business case precisa nascer com métricas auditáveis (energia, água, emissões).
    3. IA no fluxo de trabalho: a próxima onda é automação operacional com agentes integrados a processos (compras, atendimento, engenharia, finanças), reduzindo custo de ciclo e retrabalho. Implicação: sair do piloto isolado e migrar para governança de dados, integração e medição de ganho (tempo, qualidade, custo por processo).

      6) Energia, clima e sustentabilidade

      O ciclone extratropical em São Paulo foi um “teste de estresse real” para rede, poda, manutenção e plano de contingência; efeitos em cascata (energia, água, aeroportos) tornam resiliência um KPI (Key Performance Indicator) de reputação e regulação. 

      No front de transição, a CP42/2025 da Aneel sinaliza preparação do grid para escala de carregamento de veículos elétricos, com implicação em investimentos de distribuição e padrões de conexão. 

      7) Política e regulação

      O fato político-regulatório mais relevante da sexta-feira: remoção de Alexandre de Moraes, esposa e instituição vinculada da lista Global Magnitsky pelos EUA. Isso reduz fricção bilateral no curto prazo e melhora o “sentimento de risco” no eixo institucional externo, embora não elimine volatilidade doméstica. 

      8) Matriz de correlação de eventos (clusters da semana)

      ClusterRBAPERQTRVTTPECSPG
      A) Copom mantém Selic em 15%-1-1-1000
      B) Ciclone em SP e apagão0-1-10-2-1
      C) Remoção da lista Magnitsky+10000+1
      D) Aneel CP42/2025 (eletromobilidade)0+10+1+10
      E) Infra global de IA e chips (Índia/Coreia; orbital DC)000+2-10
      F) Saúde global (gene therapy; cólera; mpox)000+10-1

      Leituras (para decisão):

      • A reforça disciplina financeira: adiar o “nice-to-have”, priorizar eficiência e projetos com geração rápida de caixa. 
      • B transforma resiliência em tema de board (conselho): risco climático virou risco de continuidade operacional e reputação. 
      • C reduz ruído externo no curtíssimo prazo, mas a volatilidade política segue como variável de portfólio. 
      • D acelera a agenda “grid ready” para eletromobilidade e abre janela para serviços, hardware e software de gestão de carga. 
      • E mantém VTT pressionando CAPEX/OPEX (Operating Expenditure) de infraestrutura digital e energia. 

      9) Implicações para negócios – lente 2026 setorial

      Mantemos a matriz setorial do modelo de relatório (setor, farol, ação prioritária) para comparabilidade no tempo. 

      SetorFarolAção prioritária (versão 06–12/12)
      Agronegócio e exportaçãoVerdeMonetizar câmbio e previsibilidade de demanda externa; elevar produtividade e blindar insumos críticos via hedge e contratos.
      Energia e data centersAmareloResiliência e eficiência como “padrão de projeto”: PPAs (Power Purchase Agreements) longos, redundância elétrica, cooling e resposta a eventos extremos.
      Indústria e tecnologiaAmareloFinOps (Financial Operations), automação e IA para defesa de margem; revisar CAPEX dolarizado sob régua Selic 15%.
      Comércio e varejoVermelhoGestão de caixa e demanda: rotação de estoque, política de crédito conservadora e foco em “value for money”.

      10) Desdobrando em ações concretas para 2026

      1. FinOps como governança obrigatória em TI/Cloud (Computação em Nuvem): custo por workload, contrato por capacidade, e metas de eficiência por unidade de computação.
      2. Resiliência elétrica como agenda executiva: contingência, manutenção baseada em risco, e desenho de redundância calibrado por criticidade (não por tradição).
      3. Grid + eletromobilidade: mapear impactos de conexão de carregadores (picos, transformadores, proteção) e construir ofertas B2B (Business-to-Business) de gestão inteligente de carga.
      4. Gestão institucional “sem romantismo”: acompanhar pontos de atrito e reduzir exposição regulatória com cláusulas, cenários e trilhas de mitigação.
      5. Portfólio de inovação em IA: priorizar casos que reduzam custo fixo, encurtem ciclo decisório e aumentem produtividade mensurável.

      11) Como podemos ajudar

      O Radar 360 existe para transformar ruído em agenda executável: onde defender margem, onde acelerar crescimento e onde reduzir exposição antes que o risco seja precificado. Essa abordagem mantém consistência metodológica no tempo e cria um trilho de decisão para conselho e C-level (governança, CAPEX, contratos, energia e tecnologia). 

      Tabela – Oportunidades estratégicas (versão desta semana, mantendo o padrão do relatório) 

      EixoOportunidade centralAlavancas práticas para 2026
      Juros e caixaGanhar opcionalidade financeiraReprecificar portfólio, reduzir ciclo de caixa, CAPEX “stage-gated”
      ResiliênciaTransformar eventos extremos em vantagem operacionalPlanos de continuidade, redundância calibrada, SLAs (Service Level Agreements) realistas
      IA e nuvemProdutividade com governançaFinOps, arquitetura eficiente, automação de processos críticos
      Energia e PPAsPrevisibilidade em ambiente volátilPPAs longos, eficiência energética, gestão ativa de portfólio
      RegulaçãoAntecipar mudançasMapas de risco por projeto, cenários e “cláusulas de proteção”
      GovernançaTornar o Radar rotina decisóriaComitê mensal de risco, ritos trimestrais de cenário, backlog de decisões